
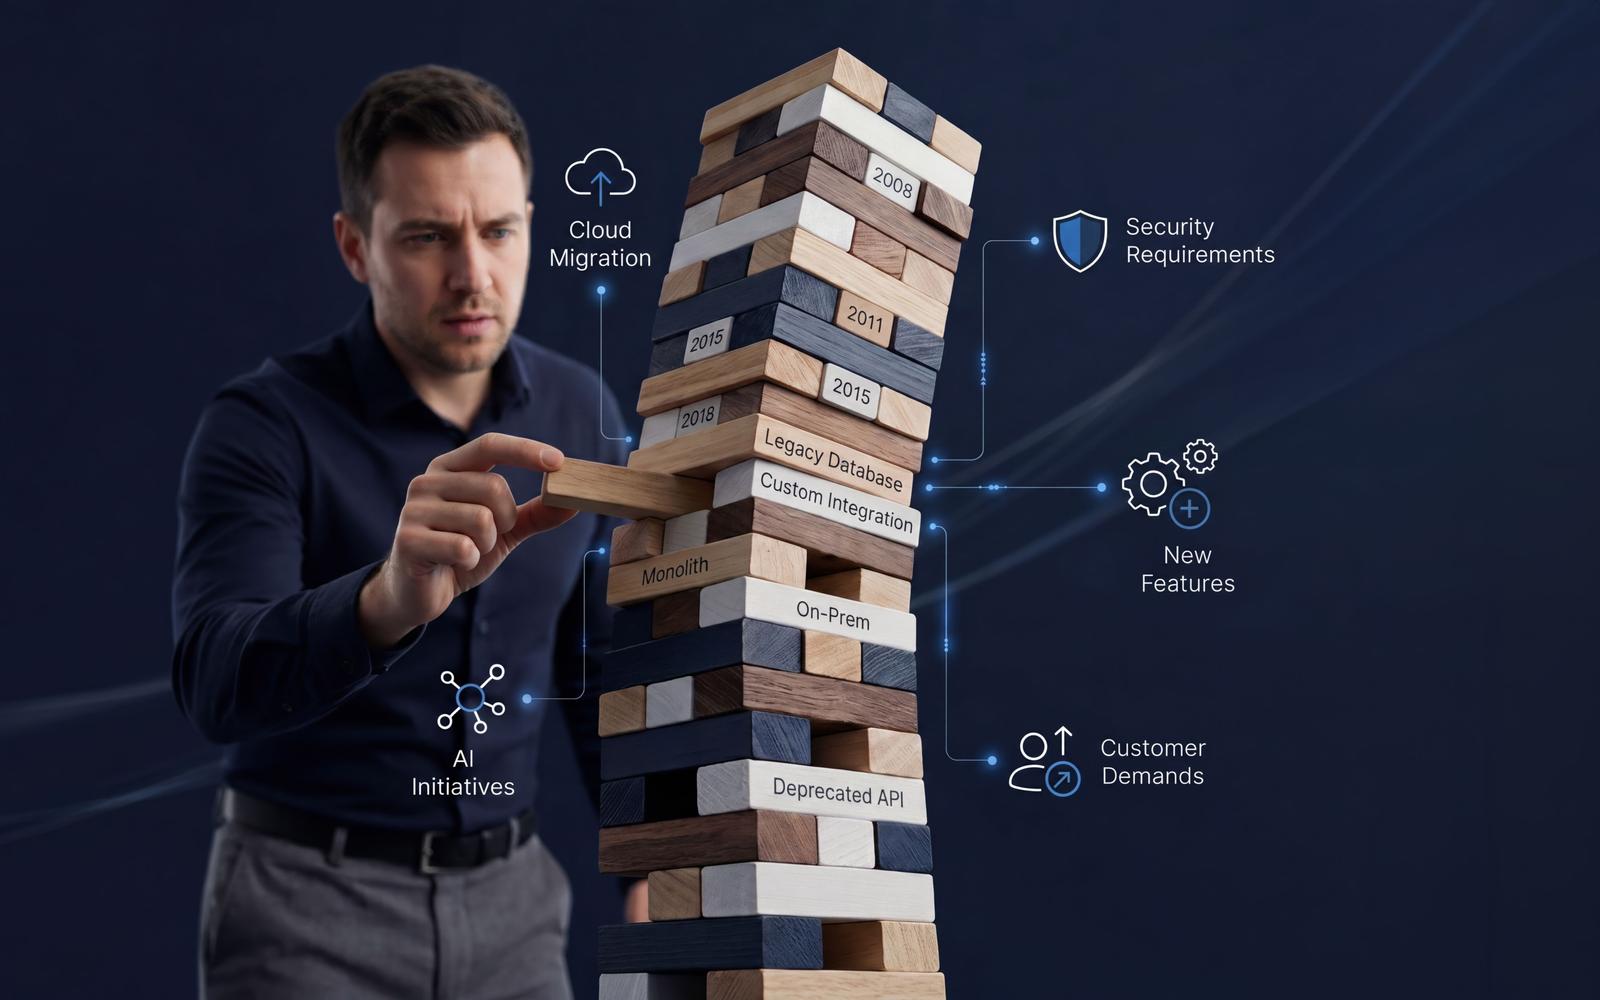
Vibe coding n'est pas mauvais en soi. Il peut aider les équipes à créer des prototypes, à tester des idées et à valider des concepts sans investir massivement dans le développement. Mais les risques changent lorsque le code généré par l’IA commence à gérer des données utilisateur réelles, des transactions financières ou des opérations critiques pour l’entreprise. Une application fonctionnelle n’est pas nécessairement prête pour la production.
La vraie question n’est pas de savoir si l’IA a écrit le code, mais que se passe-t-il si ce code échoue. Sans une supervision technique appropriée, la vitesse de développement précoce peut entraîner des vulnérabilités de sécurité, des performances peu fiables et des problèmes de maintenance coûteux.
Pour les fondateurs et les responsables techniques, le défi consiste à savoir où vibe coding a du sens, quand il devient un handicap et ce qui doit être vérifié avant la mise en ligne d'une application générée par l'IA.
Qu'est-ce que Vibe Coding et en quoi diffère-t-il du développement assisté par l'IA ?
Vibe coding est une approche de développement logiciel dans laquelle une personne décrit ce qu'elle souhaite pour un outil d'IA, accepte le code généré avec un minimum de révision et continue de l'affiner via des invites jusqu'à ce que l'application semble fonctionner. Au lieu d’examiner la mise en œuvre, ils se concentrent sur le résultat visible.
La principale différence entre vibe coding et le développement assisté par l'IA ne réside pas dans l'outil lui-même, mais dans le contrôle que les développeurs conservent sur le code.
Dans le développement assisté par l'IA, les ingénieurs utilisent l'IA pour accélérer le codage, les tests et la refactorisation tout en restant responsables de l'architecture, de la sécurité et de la qualité du code. Ils examinent les modifications générées, valident les décisions techniques et s'assurent que le logiciel répond aux exigences du projet.
Vibe coding, en revanche, donne la priorité aux fonctionnalités de travail plutôt qu'à la compréhension de la manière dont elles ont été mises en œuvre. Cela peut accélérer l’expérimentation, mais cela permet également aux problèmes techniques de passer inaperçus.
Par exemple, les deux approches pourraient utiliser l’IA pour créer une fonctionnalité d’authentification des utilisateurs. Avec vibe coding, le développeur peut s'arrêter une fois que les utilisateurs peuvent se connecter avec succès. Avec le développement assisté par l'IA, un ingénieur examine également la gestion des sessions, le stockage des mots de passe, les contrôles d'accès et les scénarios d'échec avant d'approuver la mise en œuvre.
Pourquoi Vibe Coding est-il mauvais pour les logiciels de production ?
L'hypothèse selon laquelle vibe coding est mauvais pour les logiciels de production vient d'une préoccupation réelle : le code fonctionnel ne répond pas nécessairement aux exigences de sécurité, de fiabilité ou de maintenabilité.
Selon le [Rapport sur la sécurité du code GenAI 2025 de Veracode] (https://www.veracode.com/wp-content/uploads/2025_GenAI_Code_Security_Report_Final.pdf), les modèles d'IA ont introduit des vulnérabilités de sécurité connues dans 45 % des tâches de génération de code testées. L'étude a évalué plus de 100 modèles à l'aide d'exercices de codage axés sur la sécurité sur Java, Python, JavaScript et C#. Bien que cela ne signifie pas que 45 % de tout le code généré par l’IA est vulnérable, cela montre pourquoi les fonctionnalités fonctionnelles à elles seules ne constituent pas une preuve suffisante de sécurité.
Failles de sécurité cachées
Les applications générées par l'IA peuvent contenir des contrôles d'accès faibles, des clés API exposées, des autorisations de base de données non sécurisées ou une validation d'entrée insuffisante. Ces problèmes peuvent rester invisibles lors des interactions normales des utilisateurs.
Par exemple, une application SaaS peut exiger que les utilisateurs se connectent mais ne parviennent pas à vérifier s'ils peuvent accéder aux enregistrements d'un client particulier. L'interface semble sécurisée, mais la modification d'un ID d'enregistrement dans une requête API pourrait exposer les données d'un autre client.
Performances peu fiables dans des conditions réelles
Un prototype qui fonctionne localement peut avoir des difficultés avec des utilisateurs simultanés, des ensembles de données croissants, des interruptions de réseau ou des pannes API tierces.
Sans gestion appropriée des erreurs, mécanismes de nouvelle tentative et limites de ressources, ces conditions peuvent entraîner des échecs de transactions, des opérations en double ou des temps d'arrêt. Par exemple, réessayer une demande de paiement sans protection contre l'idempotence pourrait entraîner des frais en double.
Architecture incohérente et dette technique croissante
Vibe coding développe souvent des logiciels une invite à la fois, en privilégiant la fonctionnalité immédiate plutôt que la cohérence architecturale.
Cela peut introduire une logique dupliquée, des composants étroitement couplés, des dépendances conflictuelles et des bases de données mal structurées. À mesure que l'application se développe, même de petites modifications peuvent interrompre des fonctionnalités non liées, augmentant ainsi le temps de développement et les coûts de maintenance.
Maintenance difficile et coûts à long terme plus élevés
Lorsque les développeurs ne comprennent pas le code généré, le diagnostic des échecs devient plus difficile. Les nouveaux ingénieurs devront peut-être reconstruire des décisions non documentées avant de pouvoir modifier l'application en toute sécurité.
L’absence de tests automatisés, de surveillance et de garanties de déploiement rendent ce travail encore plus coûteux. Cependant, une réécriture complète n’est pas toujours nécessaire. Si l’architecture sous-jacente est solide, une refactorisation ciblée peut suffire. La reconstruction devient plus raisonnable lorsque des failles de sécurité ou d'architecture affectent des parties fondamentales du système.
Le Vibe Coding est-il bon ou mauvais pour différents cas d'utilisation ?
Le fait que vibe coding soit bon ou mauvais dépend de la sensibilité des données de l'application, de la complexité technique et des conséquences d'une panne. Cela fonctionne mieux pour les expériences à faible risque où la vitesse compte plus que la maintenabilité à long terme. À mesure que l’impact potentiel d’une défaillance augmente, la nécessité d’une surveillance technique augmente également.
| Cas d'utilisation | Aptitude | Pourquoi |
|---|---|---|
| Prototypes et expériences de conception | Bon ajustement | Valide rapidement les idées à l'aide de maquettes ou de données non sensibles |
| Preuves de concept | Bon ajustement | Teste la faisabilité technique dans un environnement contrôlé sans dépendances de production |
| Outils internes | Conditionnel | Convient aux tâches à faible risque, mais l'accès aux dossiers clients, aux données financières ou aux systèmes critiques nécessite un examen technique |
| MVP orientés client | Conditionnel | Des projets pilotes limités peuvent être appropriés avec des contrôles d'accès testés, une surveillance et une exposition restreinte |
| Plateformes SaaS | Risque élevé | L'isolation des données multi-locataires, les intégrations, l'évolutivité et la maintenance continue nécessitent un développement dirigé par l'ingénierie |
| Systèmes de paiement et d'authentification | Évitez le code non révisé | Les échecs de sécurité ou de transaction peuvent exposer des données sensibles ou entraîner des pertes financières |
| Applications de santé et financières | Dirigé par l'ingénierie | Les données sensibles, les exigences de fiabilité et les obligations réglementaires applicables exigent des contrôles plus stricts |
Ces catégories ne sont pas absolues. Un MVP orienté client utilisant des données synthétiques peut être moins risqué qu'un outil interne avec un accès illimité aux bases de données de production.
Le facteur décisif est le coût de l'échec, et non l'étiquette du projet. Avant de vous fier à vibe coding, réfléchissez à ce qui pourrait arriver si l'application expose des données, produit des résultats incorrects ou devient indisponible.
Les applications à haut risque peuvent toujours bénéficier du développement assisté par l’IA. Ce qui change, c'est le niveau d'examen humain, de tests et de contrôle opérationnel requis avant la sortie.
Quelle est la qualité de votre application Vibe-Coded ? Un contrôle de préparation
Une application vibe-coded peut paraître terminée tout en manquant des garanties de production essentielles. Pour évaluer son état de préparation, examinez comment le système se comporte au-delà d'une démonstration réussie et si votre équipe peut vérifier sa sécurité, sa fiabilité et sa maintenabilité.
Utilisez cette liste de contrôle pour identifier les risques potentiels :
| Vérification de l'état de préparation | Panneau d'avertissement |
|---|---|
| Un ingénieur peut-il expliquer l’architecture et tracer les flux de données critiques ? | Les composants clés, les dépendances ou les décisions de traitement des données sont mal compris. |
| Les autorisations sont-elles appliquées sur le serveur ? | La modification d'un ID d'utilisateur ou d'enregistrement dans une demande API expose les données d'un autre client. |
| Les flux de travail critiques sont-ils couverts par des tests automatisés ? | L'authentification, les paiements ou les opérations principales de l'entreprise reposent principalement sur des tests manuels. |
| L’application peut-elle gérer les échecs en toute sécurité ? | Les demandes ayant échoué entraînent des opérations en double, une perte de données ou des enregistrements incohérents. |
| L’équipe peut-elle se remettre d’un échec de déploiement ou d’une perte de données ? | Les sauvegardes n'ont pas été restaurées lors des tests ou il n'existe aucune procédure de restauration vérifiée. |
| Les développeurs peuvent-ils détecter et enquêter sur les problèmes de production ? | L’absence de surveillance, de suivi des erreurs ou de journaux rend les pannes difficiles à diagnostiquer. |
| Les ingénieurs peuvent-ils modifier l’application sans casser des fonctionnalités sans rapport ? | De petits changements provoquent à plusieurs reprises des régressions ou nécessitent une vérification manuelle approfondie. |
L'identification d'un signe d'avertissement ne signifie pas automatiquement que l'application doit être reconstruite. La réponse appropriée dépend de la gravité du problème et de la profondeur avec laquelle il affecte le système.
Corrections mineures : L'architecture est solide et les lacunes isolées dans les tests, la surveillance ou la configuration peuvent être comblées sans changements structurels majeurs.
Refactoring important : La fonctionnalité de base est utile, mais des limites de composants faibles, des autorisations incohérentes ou des intégrations peu fiables nécessitent un travail d'ingénierie substantiel.
Reconstruction partielle ou complète : Des défauts fondamentaux dans le modèle de données, la conception des autorisations ou l'architecture rendent la mise en œuvre existante dangereuse ou disproportionnellement coûteuse à maintenir.
Avant de prendre une décision, évaluez l’impact commercial de chaque problème, les efforts nécessaires pour le résoudre et les risques liés au maintien de la mise en œuvre actuelle. Une évaluation technique ciblée peut aider à distinguer les problèmes qui nécessitent une attention immédiate de ceux qui peuvent être résolus au fur et à mesure de l'évolution du produit.
Comment utiliser Vibe Coding sans créer de risque de production
Le moyen le plus sûr d’utiliser vibe coding consiste à établir des contrôles techniques avant que le code généré par l’IA n’atteigne la production. Les équipes doivent définir où l’IA peut accélérer le développement, qui approuve ses résultats et quelles preuves sont requises avant la publication.
Fixez des limites claires pour le code généré par l'IA
Définissez les tâches adaptées au vibe coding et celles qui nécessitent une supervision technique directe. N'incluez jamais d'informations d'identification de production ou de données client sensibles dans les invites, et n'autorisez pas les modifications générées par l'IA à atteindre la production sans examen.
L'authentification, les paiements, les autorisations et autres fonctionnalités à fort impact doivent rester sous un contrôle technique qualifié.
Attribuez la propriété humaine et examinez chaque changement
Chaque changement généré par l'IA nécessite un ingénieur qui comprend la mise en œuvre et assume la responsabilité de sa sécurité, de son exactitude et de sa maintenance.
Avant d'approuver le code, les réviseurs doivent vérifier qu'il suit l'architecture existante, n'introduit aucune dépendance inutile et gère les erreurs de manière appropriée. Une démonstration réussie ou une explication générée par l’IA ne constitue pas une preuve suffisante de la qualité du code.
Testez au-delà du comportement attendu de l'utilisateur
Les tests ne doivent pas se limiter à savoir si une fonctionnalité fonctionne comme prévu. Avant de fusionner le code généré par l'IA, les équipes doivent vérifier que :
- Les utilisateurs non autorisés ne peuvent pas accéder aux enregistrements d'un autre client ou effectuer des actions restreintes.
- Les demandes et tentatives échouées ne créent pas de transactions en double ou de données incohérentes.
- Les flux de travail critiques de l'entreprise réussissent les tests unitaires et d'intégration automatisés.
- Les analyses de sécurité et les contrôles de dépendance ne révèlent aucun problème critique non résolu.
L’IA peut aider à générer des cas de test, mais les ingénieurs doivent définir indépendamment les scénarios de défaillance qui méritent d’être testés.
Libérez progressivement et surveillez les performances
Validez les modifications apportées à la préparation avant le déploiement. Utilisez des indicateurs de fonctionnalités ou des déploiements limités pour réduire l’exposition et surveiller les erreurs, les performances et l’utilisation inattendue des ressources.
Avant la publication, confirmez que l'équipe peut détecter les pannes critiques, identifier l'ingénieur responsable et annuler ou désactiver la modification sans perdre de données.
Flux de travail recommandé :
Prototype → Examen technique → Sécurité et tests → Sortie par étapes → Surveillance et maintenance
Chaque étape doit avoir une exigence d'approbation claire. Si les vérifications critiques échouent, la modification ne devrait pas passer en production tant que les problèmes ne sont pas résolus.
Ces contrôles permettent aux équipes de bénéficier du code généré par l'IA tout en gardant les décisions architecturales, l'acceptation des risques et l'approbation des versions entre des mains humaines.
Comment JetBase aide à rendre les logiciels générés par l'IA prêts pour la production
Transformer un prototype généré par l'IA en un produit prêt pour la production ne nécessite pas toujours de le reconstruire. La première étape consiste à identifier les parties de l'application qui sont fiables, celles qui présentent des risques et les améliorations les plus importantes pour l'entreprise.
Chez JetBase, nous abordons cela à travers une évaluation technique de l'architecture, de la sécurité, de la gestion des données, des intégrations et de l'infrastructure de l'application. Nos ingénieurs évaluent si les composants existants peuvent être conservés, doivent être refactorisés ou doivent être reconstruits. Les priorités dépendent de l'impact potentiel des pannes, des efforts nécessaires pour les résoudre et des exigences futures du produit.
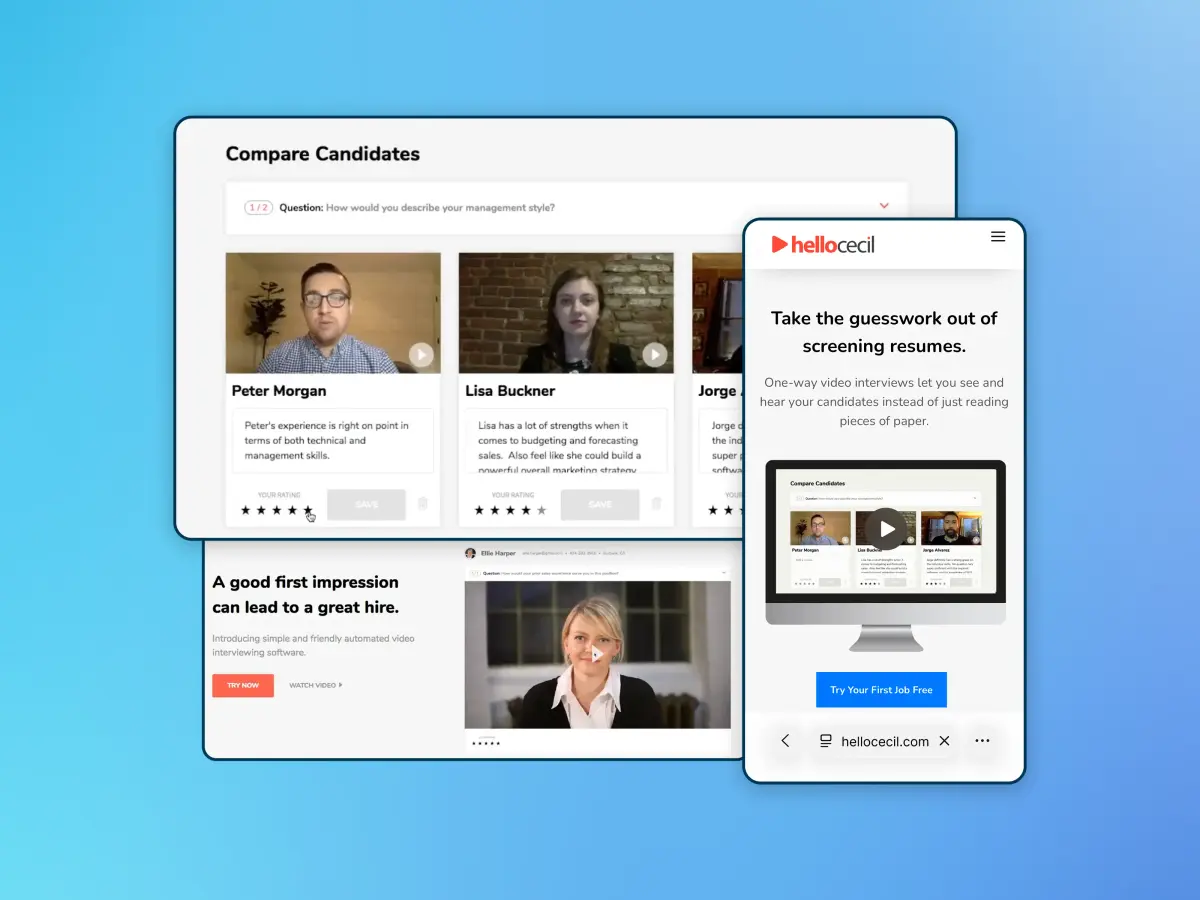
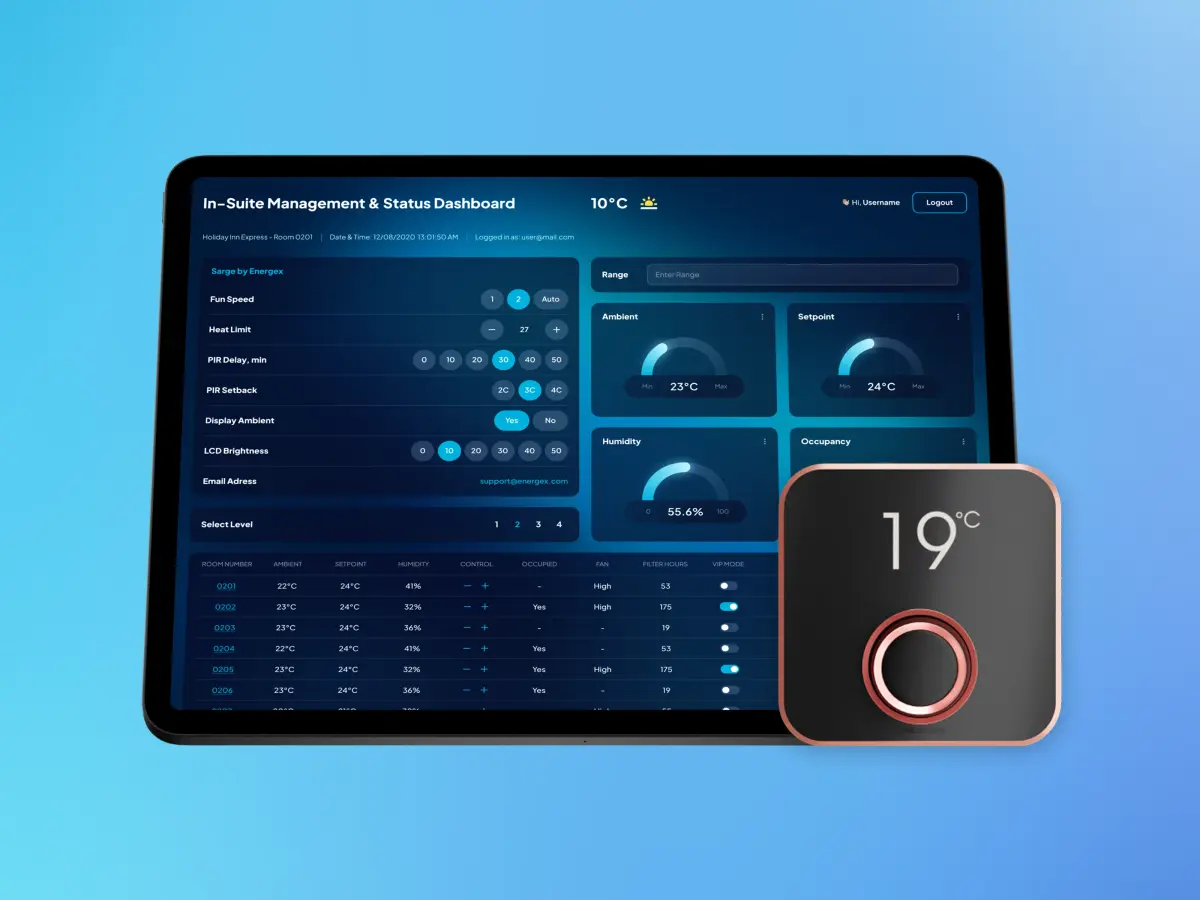
Notre expérience avec les logiciels existants démontre la valeur de cette approche. Pour Hello Cecil, nous avons contribué à transformer un MVP existant en une plate-forme d'interview vidéo entièrement fonctionnelle, répondant aux défis d'enregistrement et de stockage sur plusieurs appareils. Dans le projet Energex, nous avons optimisé la transmission excessive de données entre les thermostats intelligents et l'infrastructure cloud, réduisant ainsi les coûts cloud associés à environ un tiers de leur niveau précédent.
Pour les équipes travaillant avec des applications générées par l’IA, l’étape suivante consiste à déterminer quels risques nécessitent une attention immédiate et si des améliorations ciblées peuvent préparer le produit au lancement.
Vous envisagez de lancer ou de faire évoluer une application générée par l'IA ? Contactez JetBase pour discuter d'une évaluation technique et identifier les priorités d'ingénierie avant la production.
FAQ
Pourquoi le Vibe Coding est-il mauvais pour les applications à grande échelle ?
Vibe coding devient risqué à mesure que les applications se développent, car les modifications générées par l'IA peuvent introduire une architecture incohérente, des contrôles d'accès faibles et des dépendances difficiles à maintenir. Les systèmes plus grands nécessitent également des intégrations, une évolutivité et une surveillance fiables. Sans supervision technique, de petits problèmes de mise en œuvre peuvent se transformer en échecs de production coûteux.
Le Vibe Coding est-il bon ou mauvais pour les applications de production ?
Cela dépend de la manière dont le code généré est examiné et validé. Vibe coding peut accélérer le développement précoce, mais les applications de production nécessitent une sécurité vérifiée, une gestion des données, des flux de travail critiques, des tests automatisés et des garanties de déploiement. La préparation à la production dépend des risques et des exigences de l'application, et pas seulement de la génération ou non du code par l'IA.
À quel point Vibe Coding est-il mauvais pour les startups ?
Vibe coding peut être utile pour les startups testant des idées avec des ressources limitées. Les risques augmentent lorsque les prototypes deviennent des produits destinés aux clients ou commencent à traiter des données sensibles. Les startups doivent évaluer le coût potentiel d’un échec avant de décider si elles doivent améliorer la mise en œuvre existante ou investir dans un développement axé sur l’ingénierie.
Avez-vous besoin de réécrire une application générée par l'IA ?
Pas nécessairement. Si l'architecture de l'application est solide, des correctifs ciblés et une refactorisation peuvent remédier à ses faiblesses. Une reconstruction partielle ou complète devient plus raisonnable lorsque des problèmes fondamentaux de sécurité, de modèle de données ou d'architecture rendent le code existant dangereux ou excessivement coûteux à maintenir.